เวลามีคนถามว่า “QA เอา AI มาช่วยอะไรได้บ้าง” คำตอบที่เจอบ่อยมักจะเป็น “ให้มันเขียน test case ให้สิ” แล้วก็จบแค่นั้น
ซึ่งก็ไม่ผิดครับ แต่ผมว่ามันเป็นแค่ 10% ของสิ่งที่ทำได้จริง
โพสต์นี้ผมเลยอยากเล่าแบบไม่มีทฤษฎี ไล่จากงานที่ผมทำจริงในช่วงประมาณหนึ่งปีที่ผ่านมา กับโปรเจกต์หลายตัว ทั้งระบบขนส่ง ระบบขายหน้าร้าน ระบบประกัน ระบบเช่ารถ และระบบจัดการเอกสาร ว่า AI เข้ามาอยู่ตรงไหนของงาน QA บ้าง แต่ละข้อจะเล่าเป็น 3 ส่วนเหมือนกันหมด คือ ทำอะไร → AI พลาดตรงไหน → QA ต้องตัดสินอะไรเอง
ส่วนที่สามสำคัญที่สุด เพราะถ้าอ่านจบแล้วรู้สึกว่า AI ทำได้หมด แปลว่าผมเล่าผิด
ชื่อลูกค้า ตัวเลขเงิน เลขบิล และรายละเอียดที่ระบุตัวระบบได้ ผมตัดออกทั้งหมด เหลือแค่โครงของเหตุการณ์ที่เอาไปใช้ต่อได้
ก่อนเริ่ม — กติกาที่ใช้กับทุกข้อ
ก่อนจะเอา AI มาใช้กับงานจริง สิ่งแรกที่ต้องทำไม่ใช่หา use case แต่คือกำหนดขอบเขตให้ชัดว่ามันแตะอะไรได้ แค่ไหน
จะให้มันเข้าไปอ่านข้อมูลใน database ก็ต้องตั้งให้ user ที่มันใช้อ่านได้อย่างเดียว และบังคับที่ฝั่ง server ไม่ใช่เขียนกำชับไว้ใน prompt แล้วหวังว่ามันจะเชื่อฟัง
จะให้มันเข้าไปอ่านโค้ด ก็ต้องบอกให้ชัดว่าห้ามแก้ ห้าม commit ห้าม push ห้าม deploy คำสั่งพวกนั้นคนกดเอง
กฎที่ผมใช้จริงมีอยู่ไม่กี่ข้อ ถ้าไม่มีพวกนี้ use case ข้างล่างส่วนใหญ่จะอันตรายเกินกว่าจะทำ
- Production อ่านได้ เขียนไม่ได้ เครื่องมือที่ต่อ DB บังคับ read-only ฝั่ง server จะเขียนต้องเปิด flag แยกและขออนุมัติทุกครั้ง
- ข้อมูลลูกค้าห้ามออกนอกเครื่อง ไม่ใช้ renderer สาธารณะ ไม่ upload log ไปไหน มีสคริปต์ปิด PII ก่อนส่งข้อความออกเสมอ
- AI ห้าม commit, push, deploy เอง คนกดเท่านั้น
- ห้ามบอกว่าเสร็จถ้ายังไม่ได้พิสูจน์ test fail ต้องบอกว่า fail ข้ามขั้นตอนไหนต้องบอกว่าข้าม
กฎพวกนี้ผมเขียนไว้เป็นไฟล์เดียว โหลดเข้าทุก session เพราะสิ่งที่ AI เก่งที่สุดไม่ใช่การทำถูก แต่คือการทำเร็ว ซึ่งถ้าทิศทางผิดก็พังเร็วเหมือนกัน ขอบเขตที่ไม่ได้ระบุออกมา เท่ากับไม่มี
1. ร่าง Test Case จาก Spec — แต่ต้องซอยให้พอดีคำ
ทำอะไร
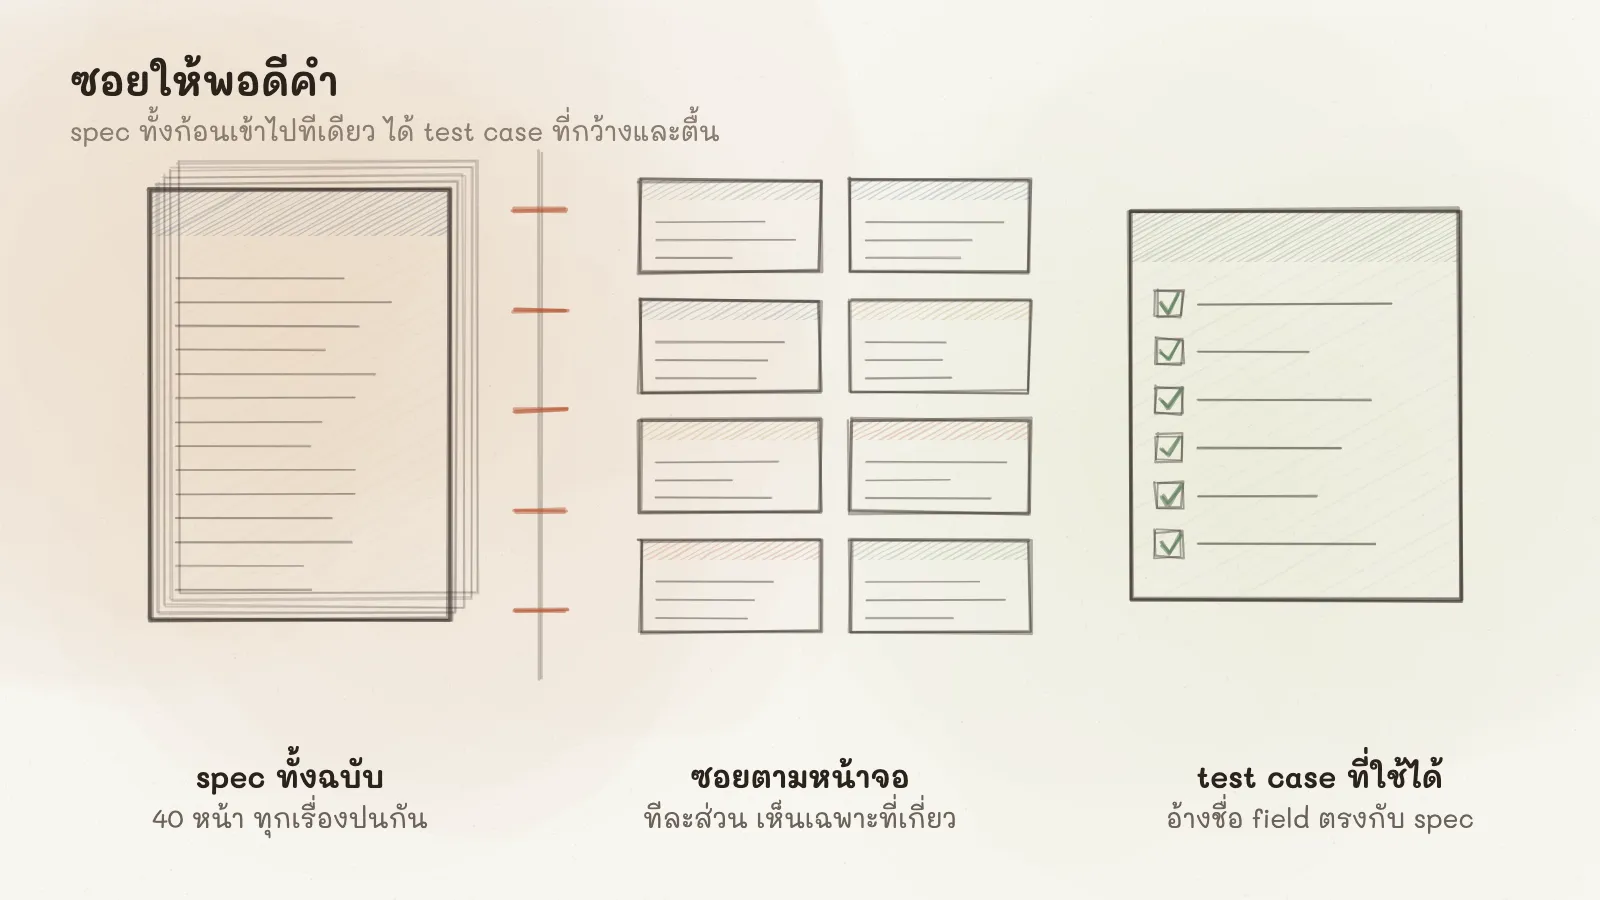
งานคลาสสิกที่ทุกคนนึกถึง แต่ปัญหาแรกที่เจอจริงคือ OpenAPI spec ของระบบใหญ่ๆ มันยาวเกินกว่าจะโยนทั้งไฟล์ให้ AI แล้วได้ของดี พอ context เยอะเกิน มันจะเริ่มเดา field ที่ไม่มีจริง หรือข้าม endpoint ไปเงียบๆ
ผมเลยให้ AI เขียนสคริปต์เล็กๆ ตัวหนึ่ง ทำหน้าที่ตัด spec ออกมา ทีละ operation พร้อม schema ที่มันอ้างถึง แล้วห่อด้วยฟอร์แมต test case ของทีม (Test Case ID, Title, Precondition, Steps, Expected Result, Priority, Type) ออกมาเป็น prompt หนึ่งก้อน จะส่งเข้า AI ต่อ หรือจะอ่านก่อนก็ได้
ผลคือ test case ที่ได้อ้างชื่อ field ตรงกับ spec ทุกตัว เพราะมันเห็นแค่สิ่งที่เกี่ยวข้อง
อีกเรื่องเล็กๆ ที่ช่วยได้เยอะคือ ปลายทางของ test case ปกติทีมนิยมทำใน Excel แต่ผมจะไม่ให้ AI สร้างไฟล์ Excel ให้ตรงๆ ผมเปิด Google Sheet เปล่าๆ ไว้ก่อนหนึ่งไฟล์ แล้วสั่งให้ AI ตอบเป็น TSV (คั่นด้วย tab) ตามคอลัมน์ของทีม ก็อปมาวางในชีตทีเดียวลงช่องพอดีทุกคอลัมน์ ทำทีละ operation แล้วเติมต่อท้ายไปเรื่อยๆ ถ้าปลายทางต้องการ Excel จริงๆ ค่อยกด download เป็น .xlsx ตอนท้าย
- AI เขียนสคริปต์ python/openpyxl ฝังข้อมูลทั้งชุดลงในโค้ด
- รันในกล่อง sandbox ของ AI ถ้าไม่มี sandbox ทำไม่ได้เลย
- ดาวน์โหลด .xlsx มาเปิดดู
- เจอผิด 1 ช่อง แก้สคริปต์ รันใหม่ โหลดใหม่ เปิดใหม่ ทั้งไฟล์
รอบละหลายพัน token + โค้ดพังได้
- เปิด Google Sheet เปล่า ใส่หัวคอลัมน์ของทีมไว้แถวแรก
- AI ตอบข้อมูลล้วนเป็น TSV ไม่มีโค้ด ใช้ได้กับ AI ทุกตัว
- ก็อป วางลงชีต tab แตกลงช่องเองพอดีทุกคอลัมน์
- เจอผิด 1 ช่อง แก้ในชีต หรือให้ AI ตอบมาแค่แถวที่แก้
ทำทีละ operation ต่อท้ายชีตเดิมได้เรื่อยๆ
ข้อควรระวังอย่างเดียวของ TSV คือช่อง Steps ต้องอยู่บรรทัดเดียว (1) ... 2) ...)
ถ้า AI ขึ้นบรรทัดใหม่ในช่อง วางแล้วแถวจะแตก บอกมันไว้ใน prompt ตั้งแต่แรกก็จบ
ส่วนที่ไม่ใช้ CSV เพราะ Steps มี comma บ่อย ต้องมา quote ยุ่ง ในขณะที่ tab แทบไม่โผล่ในข้อความปกติ
AI พลาดตรงไหน
- ชอบเขียน happy path เยอะ แล้ว negative case บางๆ ต้องสั่งแยกหมวดชัดๆ ว่า positive / negative / edge แล้วไล่นับเอง
- ละเอียดเกินจำเป็น แตกเคสย่อยจนได้ร้อยกว่าข้อ ทั้งที่หลายข้อทดสอบเรื่องเดียวกัน ยิ่งเยอะไม่ได้แปลว่ายิ่งครอบคลุม แปลว่ายิ่งต้องมีคนมานั่งรันมากขึ้นเฉยๆ
- Expected result บางข้อมาจากตรรกะที่ AI คิดเอง ไม่ใช่จาก acceptance criteria
- ถ้าไม่บอกว่า “ไม่รู้ให้ใส่ TODO” มันจะแต่งข้อมูลมาเติมให้เนียน
QA ตัดสินเอง
Priority และ business logic จริง AI ไม่รู้ว่าระบบเรามี status พิเศษอะไร หรือ flow ไหนที่ลูกค้าใช้ทุกวัน ส่วนนั้นต้องเทียบกับ requirement เองทุกครั้ง
ข้อสำคัญที่สุดของทั้งโพสต์นี้อยู่ตรงนี้ — ทุกบรรทัดที่ AI เขียน QA ต้องอ่านและเข้าใจว่ามันหมายถึงอะไร ถ้าอ่านแล้วยังไม่เข้าใจว่าเคสนี้ทดสอบอะไร แปลว่ายังส่งต่อให้ใครไม่ได้
2. API Test — สร้าง Collection ทั้งชุดจาก Spec
ทำอะไร
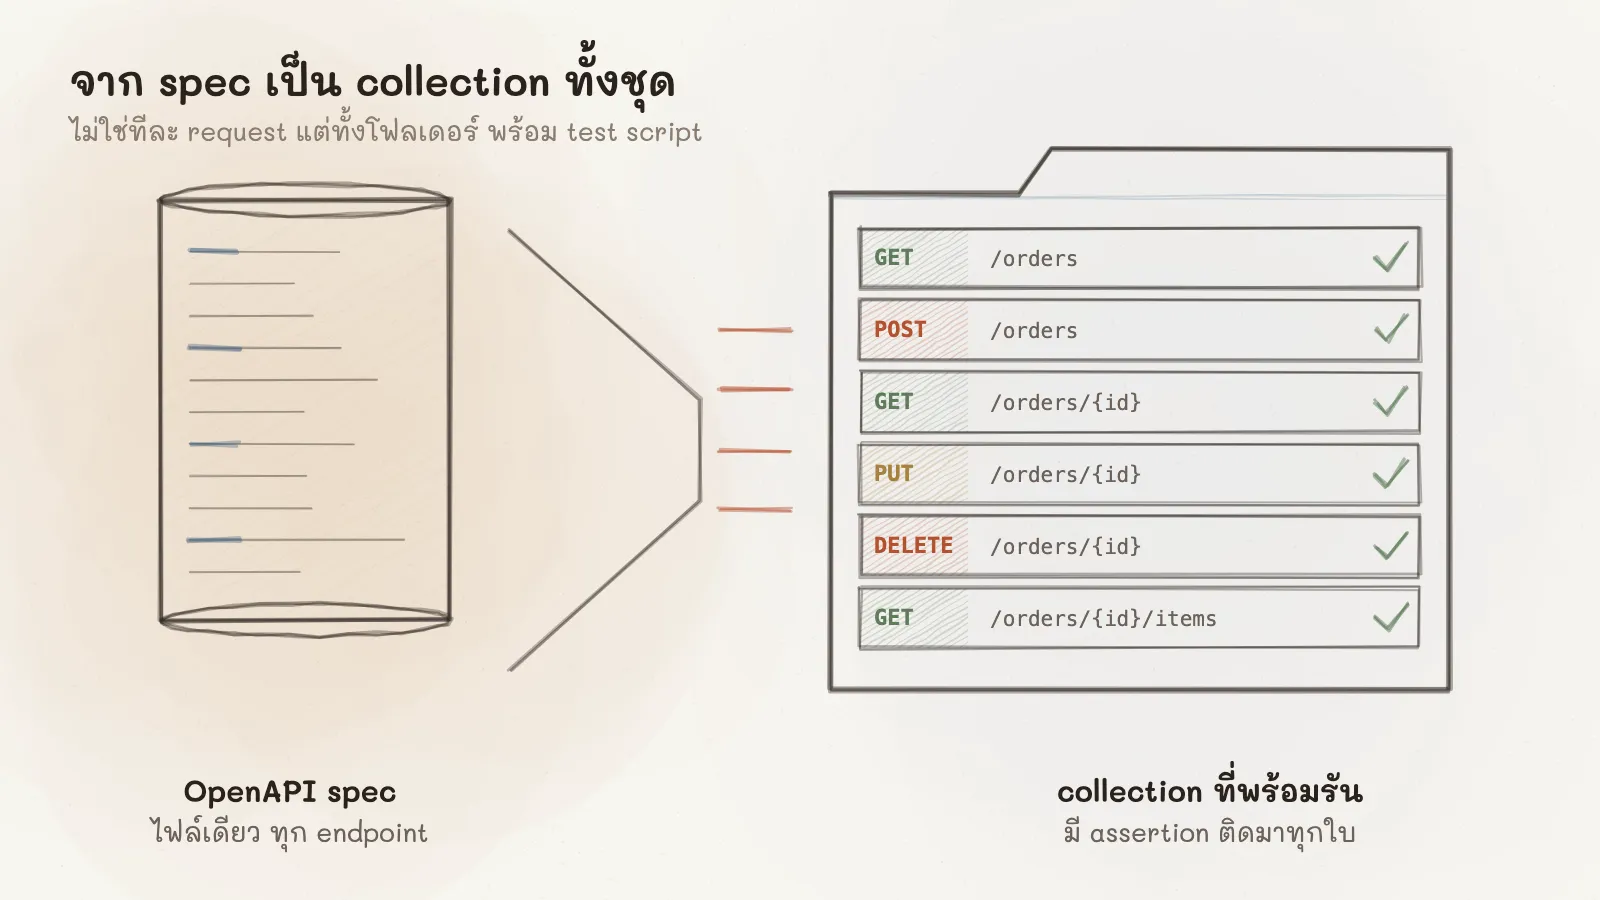
โปรเจกต์ระบบประกันมี service หลายตัว แต่ละตัวต้องมี contract test ใน Postman ถ้านั่งสร้าง request ทีละอันจาก spec ใช้เวลาเป็นวัน
ผมให้ AI อ่าน spec แล้ว generate ไฟล์ collection ให้ทั้งโฟลเดอร์ รวมถึงตอนหลังที่ทีมเปลี่ยนมาเก็บ collection เป็น YAML ใน git AI ก็เป็นคนแปลงและสร้างไฟล์ตามโครงสร้างใหม่ให้
AI พลาดตรงไหน
รอบแรก AI เดาฟอร์แมต YAML จากความรู้ทั่วไป ซึ่ง ผิด import เข้า Postman ไม่ได้เลย
ต้องเอาไฟล์จริงที่ import ได้มาให้มันดูเป็นตัวอย่าง แล้วจดกฎที่ต่างจากที่มันเดาไว้เป็น rule ในโปรเจกต์
(เช่น headers เป็น object ไม่ใช่ array, ตัวแปรชื่อ {{URL}} ไม่ใช่ {{baseUrl}})
หลังจากนั้นถึงไม่พลาดอีก
บทเรียนคือ ความรู้ทั่วไปของ AI กับฟอร์แมตเฉพาะของเครื่องมือ ไม่เหมือนกัน ต้องมีของจริงให้ดู
QA ตัดสินเอง
Test script ใน request ว่าจะ assert อะไร AI ร่างได้ แต่ว่าอะไรคือ “ถูก” สำหรับ business ต้องเทียบกับ BA เอง
3. อ่าน Commit แล้วเจอ Breaking Change ที่ไม่มีใครบอก
ทำอะไร
อันนี้เป็น use case ที่ผมไม่ได้วางแผน แต่กลายเป็นว่ามีค่ามาก
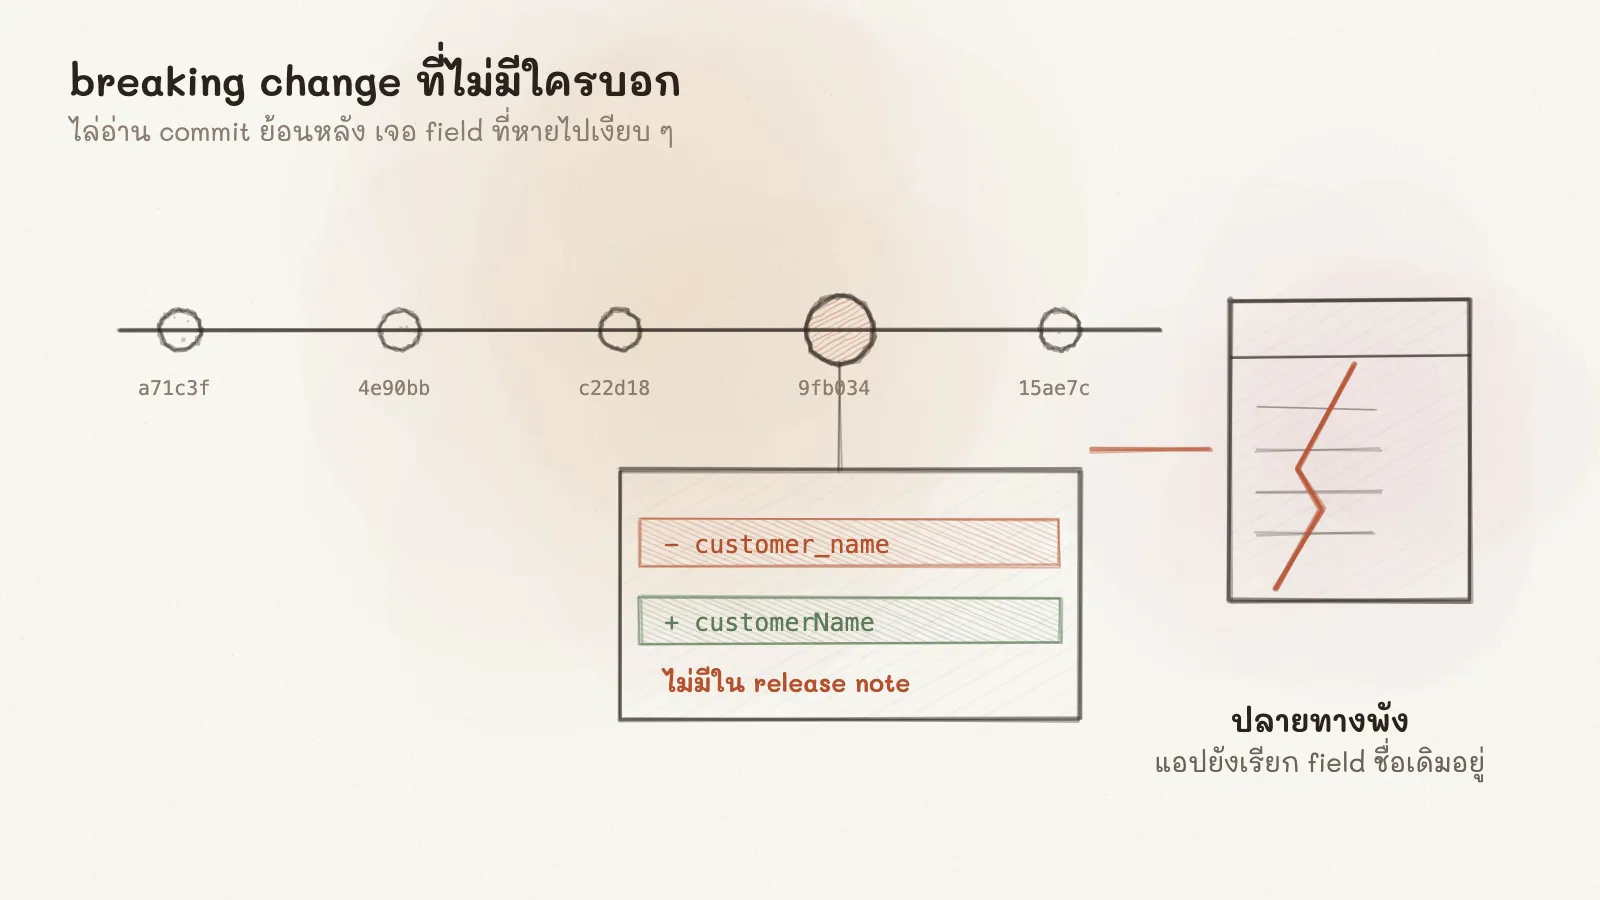
ระบบจัดการเอกสารตัวหนึ่ง อยู่ๆ Postman collection ที่เคยผ่านก็ตอบ 404 ทั้งชุด แทนที่จะไปถาม dev ผมให้ AI ไล่อ่าน commit ล่าสุดของ backend ก่อน
มันเจอว่ามี commit เพิ่ม validation ให้ header ตัวหนึ่งที่เมื่อก่อนใส่ค่าอะไรก็ผ่าน ตอนนี้ต้องเป็นค่าที่ลงทะเบียนไว้ใน DB เท่านั้น ไม่มีเอกสารไหนพูดถึงเลย มีแค่ใน commit message
แถมระหว่างไล่โค้ด มันเจอ bug จริงอีกตัวใน exception handler ที่ทำให้ response error ออกมาผิด format ซึ่งไม่เกี่ยวกับปัญหาแรกเลย
AI พลาดตรงไหน
ข้อนี้ AI ไม่ค่อยพลาด เพราะเป็นงานอ่านโค้ดล้วนๆ ที่มันถนัด แต่ต้องระวังว่ามันจะ “สรุปสาเหตุ” ทั้งที่ยังไม่ได้ reproduce ผมตั้งกฎว่า reproduce ไม่ได้ให้บอกว่ายังไม่ได้ ห้ามเดา
QA ตัดสินเอง
จะเรียกสิ่งนี้ว่า bug, requirement เปลี่ยน หรือ dev ลืมบอก อันนี้เป็นเรื่องคนกับคน AI ไม่ควรตัดสิน
4. Automation ที่ไม่ใช่ UI Test — ใช้ Playwright สร้างข้อมูล
ทำอะไร
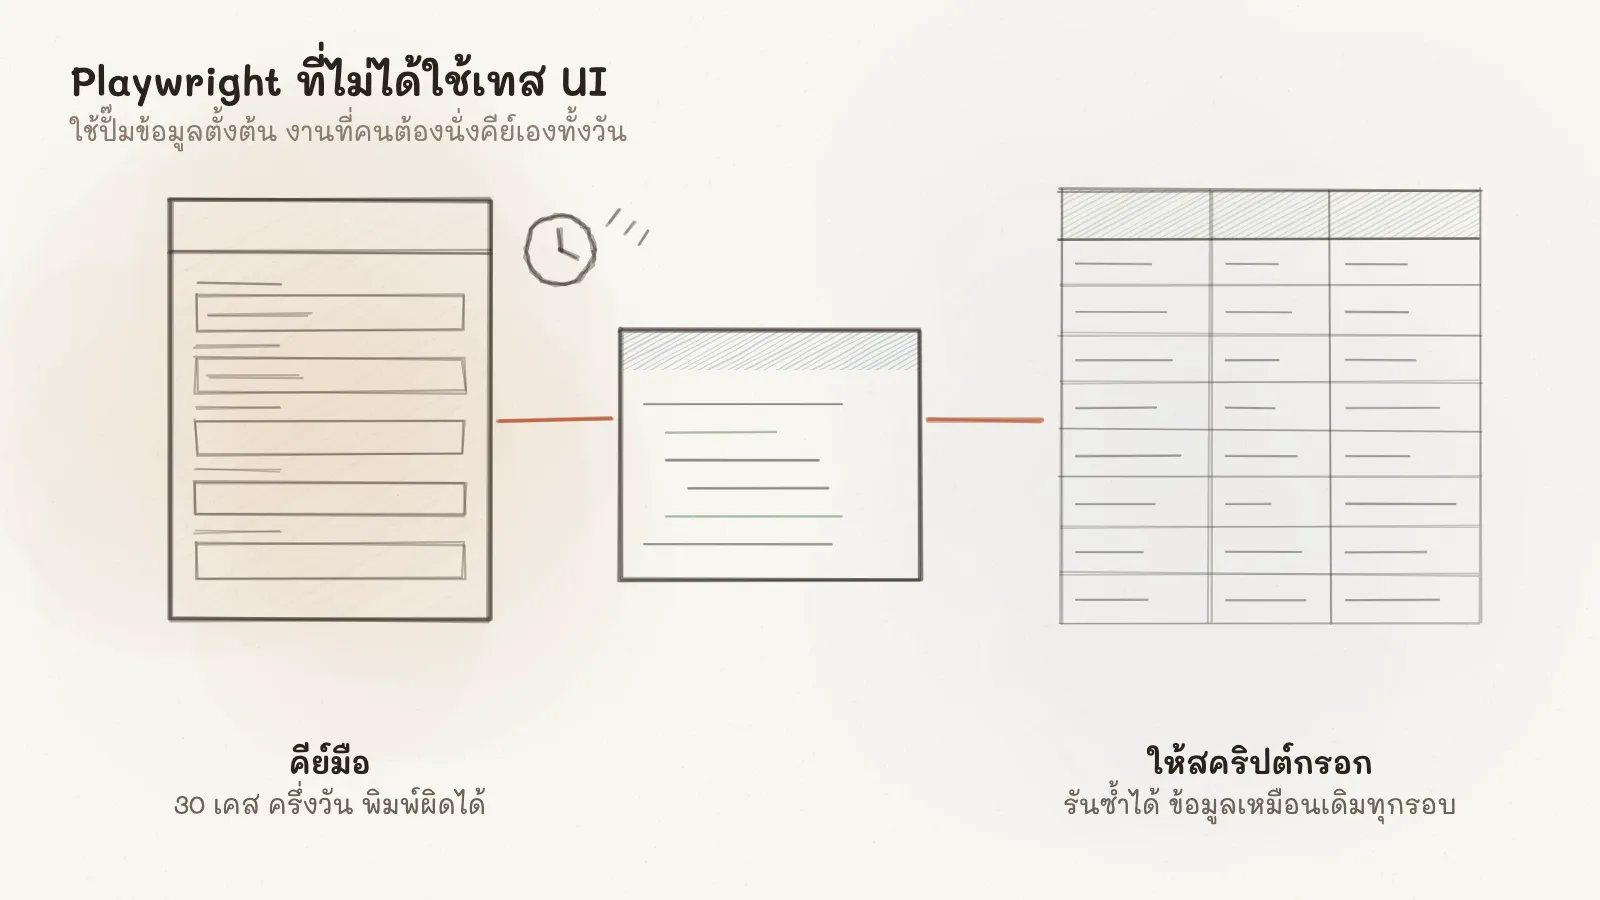
ระบบขนส่งที่ผมดูแล การจะทดสอบการคิดบิลหนึ่งรอบ ต้องมีลูกค้า สัญญา สาย รถ เที่ยววิ่งที่อนุมัติแล้ว และรอบวางบิล ถ้าสร้างมือใน UI ใช้เวลาเป็นชั่วโมงต่อหนึ่งเคส
ผมให้ AI สร้าง test suite ที่ใช้ Playwright เป็น runner แต่เป้าหมายไม่ใช่ assert UI เป้าหมายคือยิง API สร้างข้อมูลให้เหมือนการทำงานจริง สั่งคำสั่งเดียวได้ข้อมูลครบทุกกลุ่มสัญญา พร้อมสำหรับ export หรือ demo ให้ลูกค้า
ต่อมาพอลูกค้าส่งรายการแก้ไขมา ผมก็ให้ AI แปลงรายการนั้นเป็น regression set รันซ้ำได้ทุกครั้งที่ deploy ว่า behavior เดิมยังอยู่
AI พลาดตรงไหน
- เขียน scenario ใหม่แล้วไม่อัปเดตเอกสาร test case ผมเลยให้มันทำ gate ไว้ว่า spec ไหนไม่มีแถวในเอกสาร test case จะรันไม่ได้
- คำสั่ง cleanup ลบข้อมูลจริง ต้องกำกับให้ชัดว่าห้ามรันบน environment ไหน
QA ตัดสินเอง
ข้อมูลที่สร้างต้อง “เหมือนจริง” ในความหมายของ business ไม่ใช่แค่ผ่าน validation เช่น รถประเภทนี้วิ่งสายนี้จริงไหม รอบบิลตัดวันไหน อันนี้ต้องดูจากงานจริงของลูกค้า
5. Performance Test — k6 ที่ผูกกับ NFR ไม่ใช่ตัวเลขลอยๆ
ทำอะไร
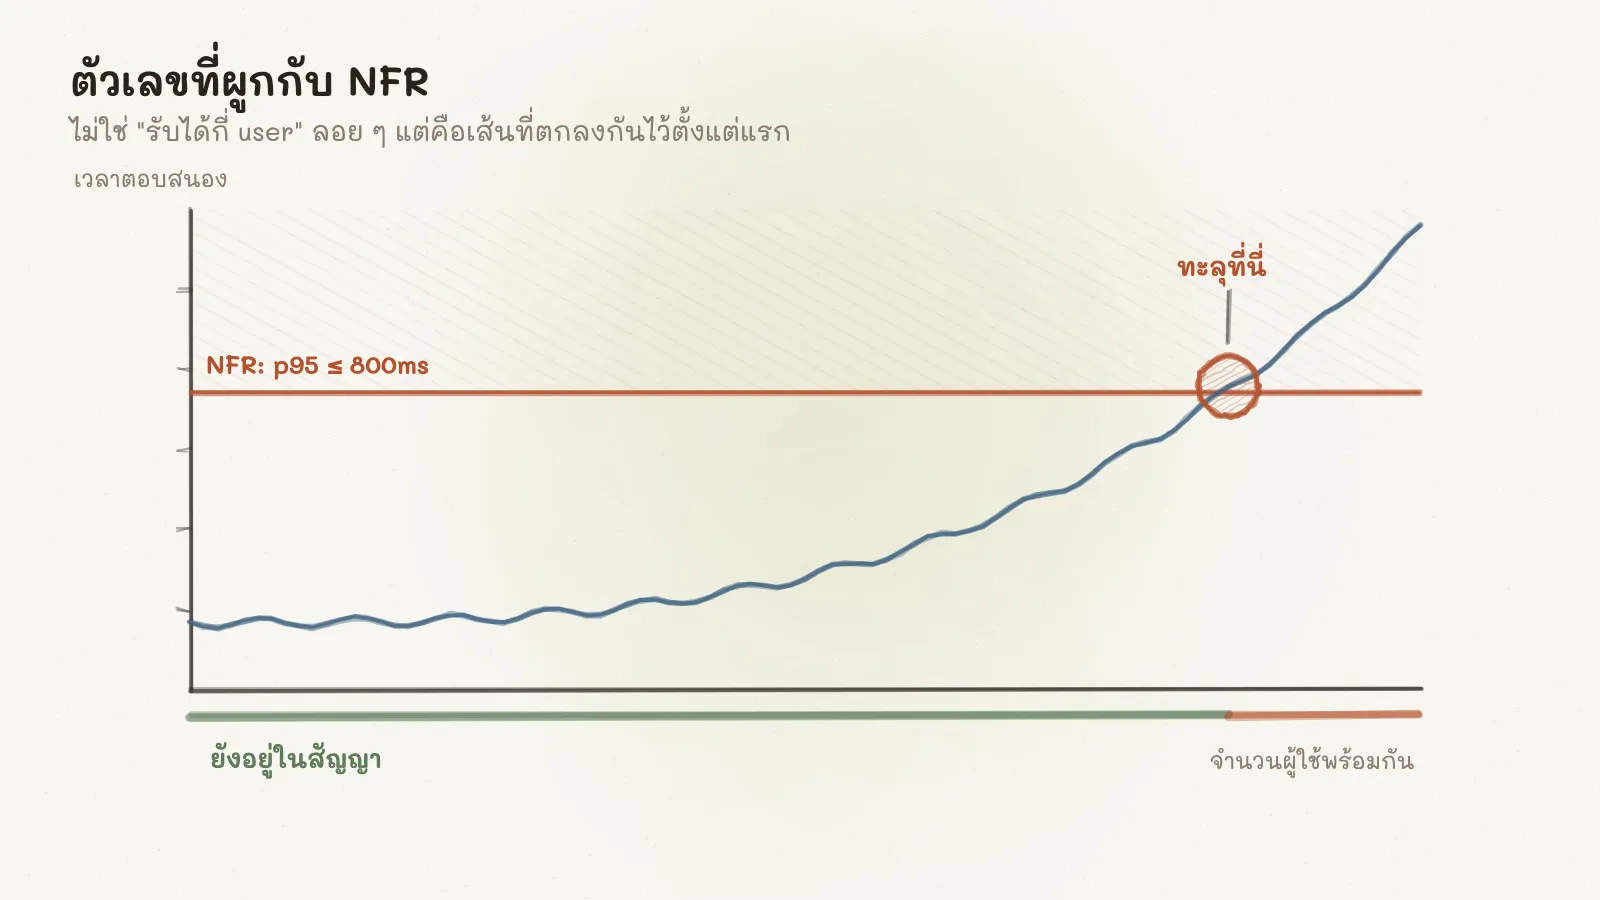
ระบบเช่ารถต้องส่งผล performance test ตาม NFR ใน BRD ผมให้ AI สร้าง k6 harness ที่มี scenario แยกตามขั้นของ user journey ตั้งแต่โหลดหน้า public, ค้นหา, จอง ไปจนถึงชำระเงิน และมีตัวหนึ่งที่รันบน Chromium จริงเพื่อเก็บ Web Vitals
จุดที่ผมชอบคือ AI ช่วยผูกเกณฑ์ตัดสินกลับไปที่ข้อใน BRD ให้เลย ว่าตัวเลขนี้มาจากข้อไหน ไม่ใช่ threshold ที่ตั้งกันเอง
AI พลาดตรงไหน
- ตอนแรกมันใช้ p95 เป็นเกณฑ์ ซึ่ง “ดูถูกต้อง” ในสายตาคนทำ performance แต่ BRD เขียนว่า “Average” ต้องใช้ average ตามสัญญา
- เกณฑ์ error rate ที่มันใส่มา ไม่มีใน BRD เลย เป็นค่าที่ AI ใส่ตามความเคยชิน ต้องกำกับไว้ว่าเป็นเกณฑ์ภายใน ยังไม่ได้รับการยืนยัน
QA ตัดสินเอง
จะยิง UAT เมื่อไหร่ ต้องคุยกับใครก่อน ผมให้สคริปต์บล็อก UAT ไว้เลย จนกว่าจะใส่ flag ยืนยันเอง เพราะยิง load ผิด environment คือหายนะ
6. Security Review — เจอช่องโหว่ระดับ Critical จากการอ่านโค้ด
ทำอะไร
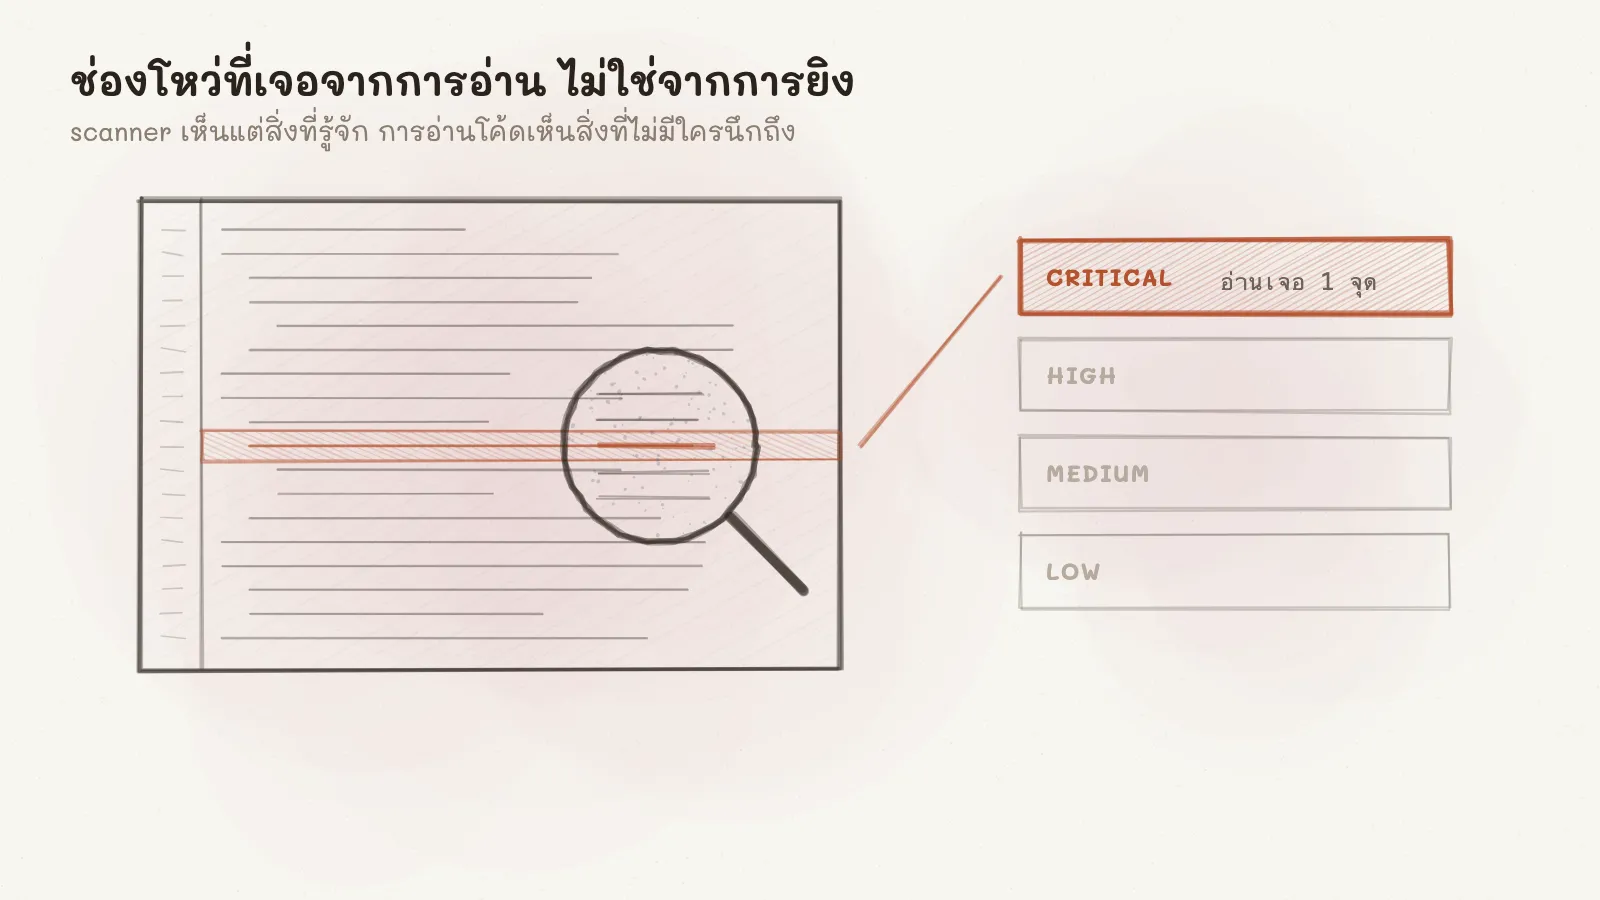
ก่อนส่งมอบ ผมให้ AI ทำ static review เรื่อง authorization ของ backend ทั้งตัว ไล่ทุก route ทุก controller ว่าแต่ละอันมี guard อะไรบ้าง
ผลที่ได้คือช่องโหว่ระดับ Critical หนึ่งตัว user ระดับเจ้าหน้าที่ทั่วไป สามารถแก้ข้อมูลตัวเองให้กลายเป็น superadmin ได้ เพราะ endpoint แก้ไข user ตรวจแค่ประเภท user แต่ไม่ได้ห้ามส่ง field ประเภทมาด้วย และเจอระดับ High อีกกลุ่ม ที่ frontend ซ่อนปุ่มไว้ แต่ API ไม่ได้เช็ค permission จริง
อีกงานหนึ่งคือ security scanner ของทีมรายงานมาร้อยกว่า finding ผมให้ AI ไล่ triage ทีละตัว สรุปได้ว่า เป็น false positive ทั้งหมด เพราะ scanner มอง ORM เป็น NoSQL ทั้งที่ไม่ใช่ พร้อมเหตุผลต่อบรรทัดให้ทีมตรวจทานได้
AI พลาดตรงไหน
Static review ไม่เท่ากับ pentest จริง มันบอกได้ว่าโค้ด “ดูเหมือน” มีช่องโหว่ แต่ผมต้องยิงจริงบน dev เพื่อยืนยันก่อนจะเรียกว่า Critical
QA ตัดสินเอง
Severity และลำดับการแก้ รวมถึงจะบอกลูกค้าอย่างไร
7. สืบ Incident จาก Log — คำถาม “ตอนนี้มีคนใช้อยู่ไหม” ใน 0.4 วินาที
ทำอะไร
ระบบ production ส่วนใหญ่เก็บ log การใช้งานของผู้ใช้ไว้อยู่แล้ว แค่คนละรูปแบบกัน อยู่บน Azure ก็มักเป็น Application Insights ไม่ใช่ Azure ก็อาจเป็น log ที่ส่งไปไว้บน Grafana
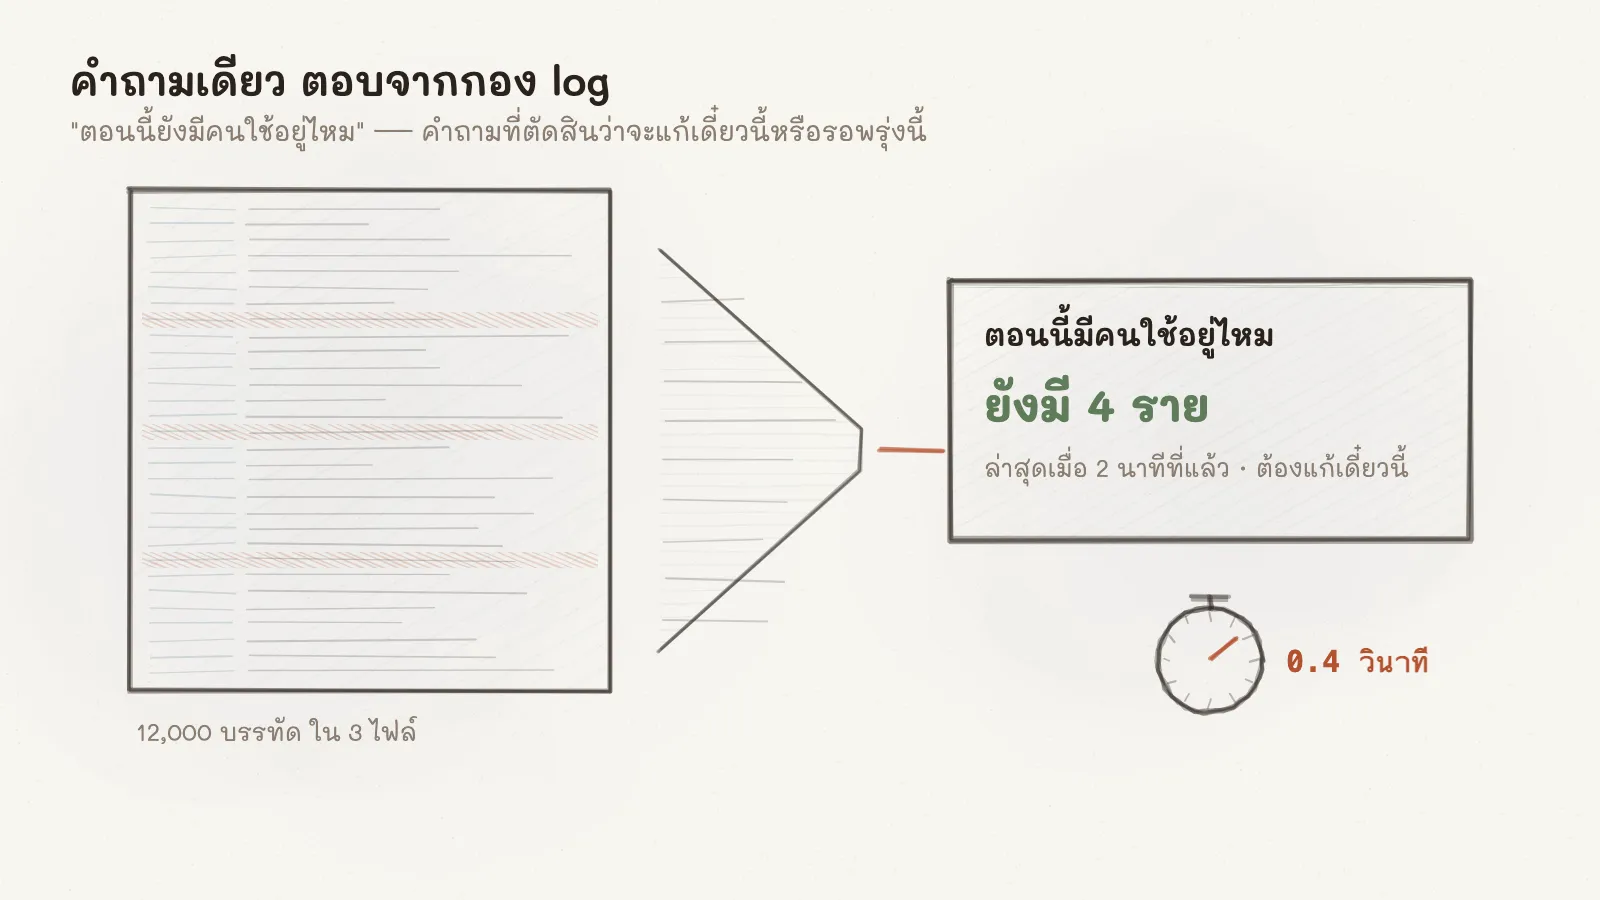
ระบบขายหน้าร้านมี log อยู่บน Grafana Cloud หลาย service ทุกครั้งที่จะทำอะไรกับ production ผมต้องรู้ก่อนว่าตอนนี้มีสาขาไหนขายของอยู่ไหม
รอบแรกๆ ผมให้ AI query Loki ทีละคำสั่ง ใช้เวลาหลายนาที
พอเห็นว่าถามคำถามเดิมซ้ำบ่อย เลยให้มันเขียนเป็นสคริปต์ตัวเดียว
ตัด /health กับ /metrics ออกให้เหลือแค่คำขอจากคนจริง
สรุปว่าใครขยับล่าสุด สาขาไหน มี 5xx กี่ครั้ง แล้ว exit code บอกเลยว่าเงียบหรือไม่เงียบ
ผลคือคำถามที่เคยใช้เวลาหลายนาที ตอบได้ในเสี้ยววินาที และใช้ต่อใน loop ได้ “รอจนร้านเงียบก่อนค่อยแก้ข้อมูล”
Incident จริงที่ใช้วิธีนี้
- บิลไม่สำเร็จเพราะฝั่งชำระเงินตอบช้ากว่าเวลาที่ระบบรอ ระบบเลยยกเลิกบิลและคืนสต็อกไปแล้ว แต่เงินเข้าจริงและใบเสร็จออกไปแล้ว AI ช่วยไล่ timeline จาก log ของหลาย service มาต่อกันจนเห็นภาพ
- DB connection ของ cluster เต็ม เพราะทุก environment ของทุก service อยู่บน cluster เดียวกัน AI ช่วยนับว่ามีกี่ connection มาจากไหน แล้วเขียน incident report พร้อมข้อเสนอแก้ต้นเหตุ
อีกโปรเจกต์ที่ log อยู่บน Azure App Insights ก็ทำแบบเดียวกัน มี helper ตัวเล็กๆ แปลง KQL เป็นตาราง แล้วให้ AI ไล่ดู 14 วันย้อนหลัง เจอทั้ง SSL ที่ล้มทุกครั้ง, adapter ที่ตอบ 200 ทั้งที่ระบบปลายทางตอบ 400, และ health check ที่ตอบ 404 มาตลอดโดยไม่มีใครสังเกต
AI พลาดตรงไหน
ชื่อสาขาและเครื่องใน log เป็น UUID AI จะเดาชื่อไม่ได้ ต้องมี mapping table ให้ และมันชอบสรุปเร็ว ต้องบังคับให้แสดง log บรรทัดจริงประกอบทุกข้อสรุป
QA ตัดสินเอง
จะเรียกว่า incident ระดับไหน จะแจ้งลูกค้าเมื่อไหร่ และข้อมูลไหนที่ต้องซ่อม
8. ซ่อมข้อมูล Production — ส่วนที่น่ากลัวที่สุด แต่มีวินัยที่สุด
ทำอะไร
ต่อจากข้อที่แล้ว พอ incident จบ จะมีข้อมูลค้างที่ต้องซ่อม บิลที่สถานะผิด คูปองที่ถูกนับซ้ำ ยอดคงเหลือในประวัติสต็อกที่ไม่ตรง
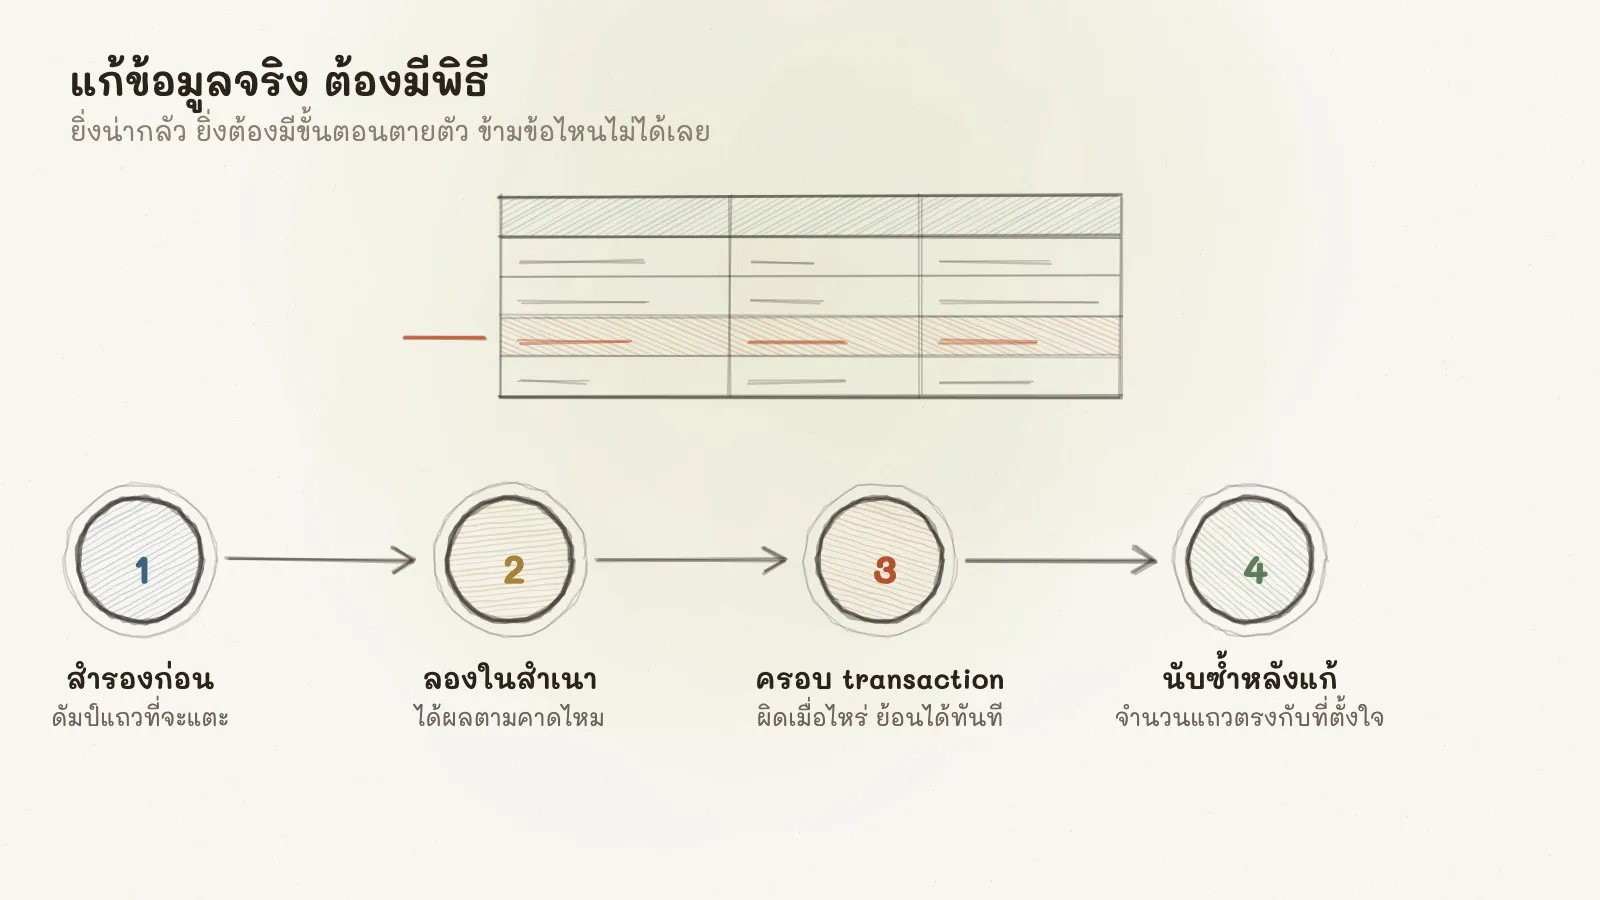
ทุกชุดซ่อมที่ AI เขียน ต้องผ่านกติกาเดียวกันหมด
- โหมดซ้อมเป็นค่าตั้งต้น รันครบทุกขั้นแล้ว ROLLBACK จะเขียนจริงต้องส่ง flag แยก
- backup ก่อน และตรวจว่า backup ใช้ได้จริง นับ row เทียบกับ DB ก่อนยอมแก้
- ทุกอย่างอยู่ใน transaction เดียว ด่านตรวจไหนไม่ผ่านให้ RAISE EXCEPTION ย้อนทั้งชุด
- มี undo และซ้อม undo ให้เห็นก่อนรันจริง
- ซ้อมบน DEV ก่อน PROD เสมอ ซึ่ง DEV เป็น clone ของ UAT ที่ mask ชื่อสมาชิกแล้ว
- รันซ้ำต้องไม่พัง ด่านแรกต้องจับได้ว่าแก้ไปแล้วแล้วหยุดเอง
- มี diagram ก่อน/หลัง ทุกชุด ให้เจ้าของระบบดูว่าจะเปลี่ยนอะไรโดยไม่ต้องอ่าน SQL
แล้วทุกครั้งที่รันจริงต้องลง changelog ว่าแก้อะไร ค่าเดิมคืออะไร backup อยู่ไหน กู้คืนอย่างไร
AI พลาดตรงไหน
ระบบเป็น microservice แบบ database-per-service ที่ sync ข้อมูลข้าม service ผ่าน event แก้ตารางต้นทางแล้ว ตาราง projection ในอีก service ไม่ได้ rebuild เอง รอบแรก AI แก้แค่ต้นทาง ยอดในหน้าจออีกระบบเลยไม่ตรง ต้องจดไว้เป็นกฎว่าแก้ข้อมูลมือต้องไล่สำเนาให้ครบ
QA ตัดสินเอง
จะแก้หรือไม่แก้ ทุกชุดที่ AI เตรียม ผมเป็นคนอ่าน diff ทุกบรรทัด รันโหมดซ้อม ดูผล แล้วค่อยเป็นคนสั่งรันจริงเอง AI ไม่เคยได้สิทธิ์เขียน production โดยไม่ผ่านมือคน
9. เอกสาร — ตั้งแต่คู่มือลูกค้า ถึงตัวเฝ้าคำต้องห้าม
ทำอะไร
คู่มือผู้ใช้และเอกสารระบบของหลายโปรเจกต์ ผมให้ AI ร่างจาก source จริง คือ OpenAPI กับโค้ด ไม่ใช่ให้มันนึกเอาเองว่าระบบทำงานยังไง
งานที่กินเวลาที่สุดของคู่มือไม่ใช่ตัวหนังสือ แต่เป็นรูป ต้องไล่เก็บ screenshot ทีละหน้าจอ ครอปให้เหลือเฉพาะส่วนที่กำลังพูดถึง วางให้ตรงกับขั้นตอนที่มันอธิบาย แล้วเขียนคำบรรยายใต้รูปทุกใบ ผมให้ AI ทำตั้งแต่ร่างขั้นตอน ไปจนถึงจัดรูปจาก UAT ลงในแต่ละขั้นพร้อมคำบรรยาย แล้วเรนเดอร์ทั้งชุดเป็นเว็บด้วย Docusaurus หรือ Astro
เรื่องนี้ผมเคยเล่าละเอียดไปแล้วใน โพสต์เรื่องรวมเอกสารด้วย Astro
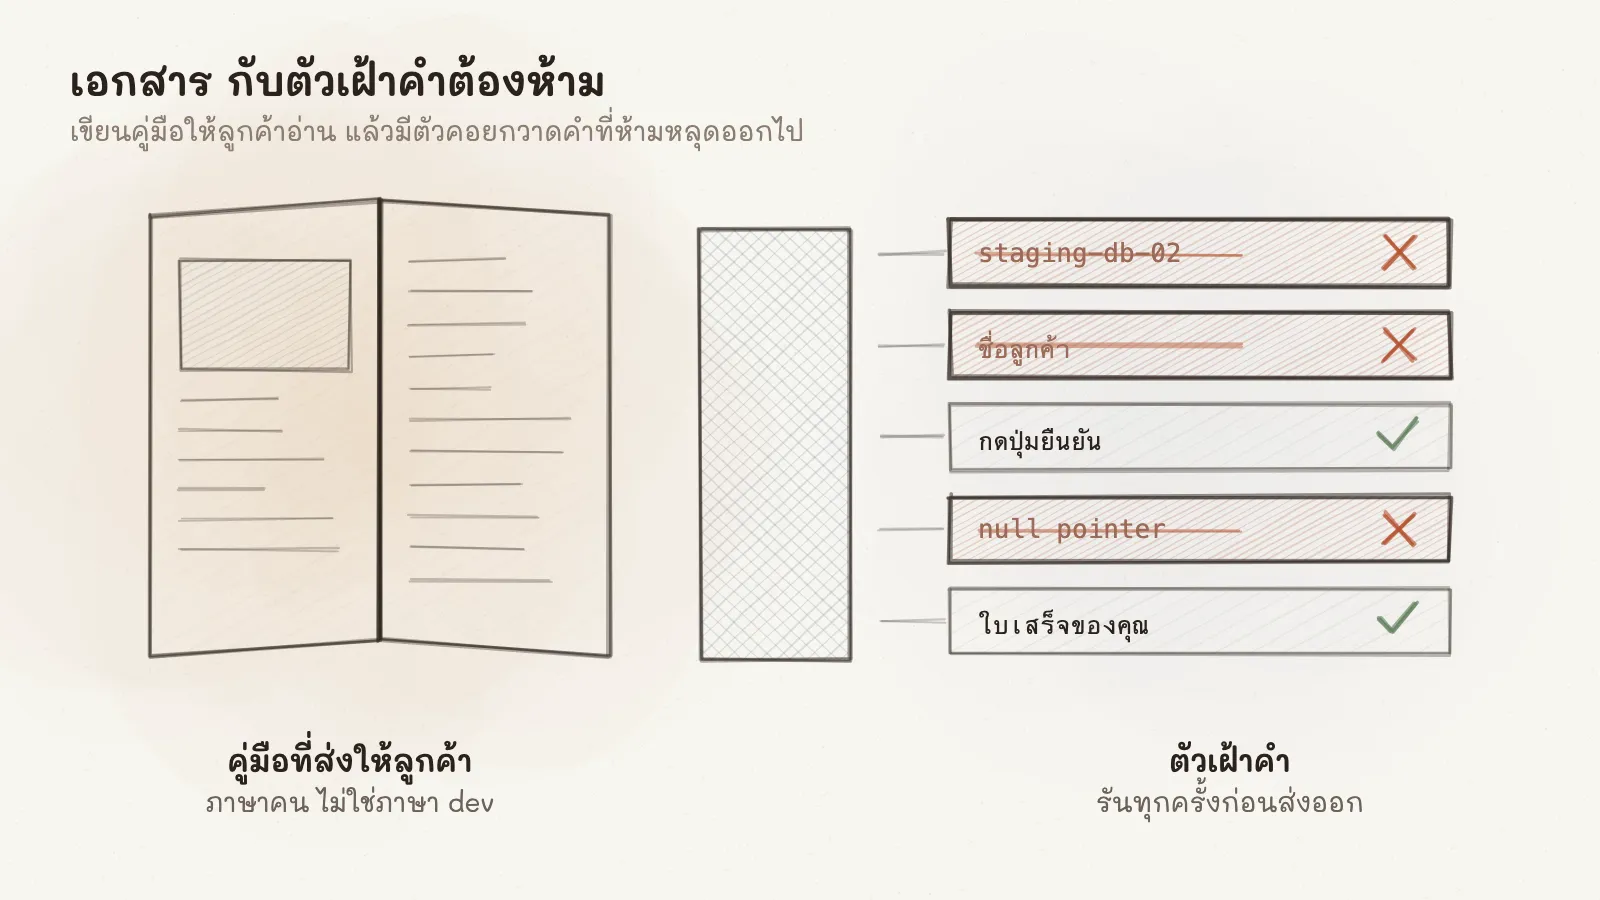
สิ่งที่อยากเพิ่มในโพสต์นี้คือเครื่องมือรอบๆ เอกสาร ที่ AI ช่วยสร้างให้ แล้วช่วยชีวิตผมหลายครั้ง
- ตัวสแกนคำต้องห้าม เอกสารส่งลูกค้าห้ามมีชื่อ branch, endpoint, ชื่อเทคโนโลยีเบื้องหลัง สคริปต์นี้ไล่ทุกไฟล์ก่อน build เจอเมื่อไหร่ fail ทันที มี baseline ของคำที่รีวิวแล้วยอมให้อยู่
- ตัวเฝ้า spec ของ vendor partner บางรายเปลี่ยน spec โดยไม่บอก สคริปต์นี้ดึงหน้า doc มาเทียบกับ snapshot เดิม แล้วรายงานว่าอะไรเปลี่ยน
- sync spec ก่อนเขียน ดึง OpenAPI จาก service repo มาทับใน docs repo ก่อนทุกครั้ง เพราะ spec ฝั่งเอกสารล้าหลังได้เสมอ
- AI Traceability report ตอนส่งมอบ ผมให้ AI ไล่ commit บน production ที่มันมีส่วนแตะ จัดกลุ่มตามความเสี่ยง ให้ dev ที่รับช่วงต่อรู้ว่าต้อง re-verify อะไรก่อน
AI พลาดตรงไหน
มโน UI ที่ไม่มีจริง ใช้ชื่อ field ผิด และเขียน “เราพลาดยังไง” ลงในเอกสารลูกค้า ซึ่งเป็นสิ่งที่ห้ามเด็ดขาด ตัวสแกนคำต้องห้ามเกิดมาจากความพลาดพวกนี้แหละครับ
QA ตัดสินเอง
อะไรควรอยู่ในเอกสารลูกค้า อะไรควรอยู่เอกสารภายใน และโทนเสียงของเอกสาร
สิ่งที่เห็นเหมือนกันทุกข้อ
ถ้าอ่านย้อนดู จะเห็น pattern ซ้ำ
AI เก่งเรื่อง: อ่านของเยอะๆ เร็ว, ไม่ลืมโครง, เสนอมุมที่เรานึกไม่ถึง, ทำงานซ้ำๆ ให้เป็นสคริปต์
AI พลาดเรื่อง: business logic ที่ไม่ได้อยู่ในโค้ด, ฟอร์แมตเฉพาะของเครื่องมือ, ผลข้างเคียงข้ามระบบ, และการ “สรุป” เร็วกว่าหลักฐาน
QA ต้องถือไว้เอง: severity, priority, การตัดสินว่าอะไรถูกสำหรับธุรกิจ, และทุกปุ่มที่กดแล้วย้อนกลับไม่ได้
สิ่งที่เปลี่ยนไปจริงๆ ในงานผมไม่ใช่ว่า QA เขียน test case น้อยลง แต่คือ เวลาที่เคยหมดไปกับงานทำซ้ำ ตอนนี้ไปอยู่กับการคิดว่า “ถ้า user ทำแบบนี้จะเกิดอะไร” ซึ่งเป็นงานที่ AI แทนไม่ได้ และเป็นงานที่ทำให้ QA เป็น QA
ถ้าอยากเริ่ม ผมแนะนำเริ่มจากข้อ 1 กับข้อ 7 ข้อ 1 เพราะพลาดแล้วไม่เจ็บ ข้อ 7 เพราะเห็นผลเร็วที่สุด และเป็นข้อที่ทำให้ผมเชื่อว่าของนี้ใช้จริงได้
ส่วนข้อ 8 อย่าเพิ่งครับ ถ้ายังไม่มีกติกาครบ 7 ข้อในนั้น